11 月 17 日,OpenAI 正式发布 GPT-6.2 Astra 与 GPT-6.2 Sol。前者面向最复杂的项目,后者定位高效、通用的日常主力。两款模型已进入 ChatGPT Work、Codex 和 OpenAI API,API 型号分别为 gpt-6.2-astra 与 gpt-6.2-sol。
这次更新最值得开发者关注的,不只是“能力又提升了”,而是 OpenAI 把两类任务的分工做得更清楚:Astra 负责突破难题,Sol 负责以更低成本完成高频工作。
Astra:旗舰能力升级,常规输入输出价降低 20%
OpenAI 将 GPT-6.2 Astra 称为新的前沿模型,重点提升复杂专业工作、科学研究、编程、计算机操作,以及幻灯片、表格和文档等交付物的质量。它不只是生成一段答案,更强调按照模板和行业规范完成整份成果。
官方公布的两组数字很能说明升级方向:
- 在考察多步骤专业工作的 Agents’ Last Exam 上,GPT-6.2 Astra 比 GPT-6 Astra 高 5.2 分,厂商测算的任务成本不到后者的三分之一;
- 在 OpenAI 内部的 GDPval v2 上,它比 GPT-6 Astra 高 6.2 个百分点,同时减少 22% 输出 token。
也就是说,Astra 的升级同时指向结果质量和 token 效率,而不只是追求更长的回答。
价格也更直接。在 Standard 档、输入不超过 27.2 万 token 的条件下,GPT-6.2 Astra 每百万普通输入/输出 token 的价格分别为 8/40 美元💵,GPT-6 Astra 为 10/50 美元💵,两项均下降 20%;缓存读取从 1 美元💵降至 0.40 美元💵,下降 60%。
Sol:价格不变,但更接近旗舰
如果说 Astra 的任务是抬高能力上限,Sol 的任务就是让日常主力更值得默认使用。
OpenAI 表示,GPT-6.2 Sol 在 GDPval v2 上比 GPT-6.1 Sol 提升 5.3 分。更引人关注的是 Cognition 的 FrontierCode 2.0:两款模型都使用最高推理档时,Sol 与 Astra 的成绩差距只有 0.5 分,厂商测算的 Sol 任务成本约为 Astra 的 五分之一。
这并不意味着 Sol 在所有编程任务上都只比 Astra 差一点。FrontierCode 2.0 考察的是真实代码库改动能否达到维护者的合并标准,上述结果也限定在该评测及其配置内。但它至少提供了一个清晰信号:日常开发不该未经比较就默认使用最贵型号。
GPT-6.2 Sol 的 API 标价没有上涨。相同 Standard 短上下文条件下,每百万普通输入/缓存读取/输出 token 分别为 2/0.10/10 美元💵,与 GPT-6.1 Sol 相同。
一笔固定用量账:Sol 是 Astra 的四分之一
把两款新模型放在同一个算术例子里:假设一次请求消耗 10 万普通输入 token 和 1 万输出 token,不使用缓存,不计工具调用、重试和其他费用:
在相同 token 用量下,Sol 的账单是 Astra 的 25%。这与 FrontierCode 2.0 中“约五分之一任务成本”不是同一个口径:前者固定 token 用量,后者包含模型在特定评测中的实际消耗,不能混为一谈。
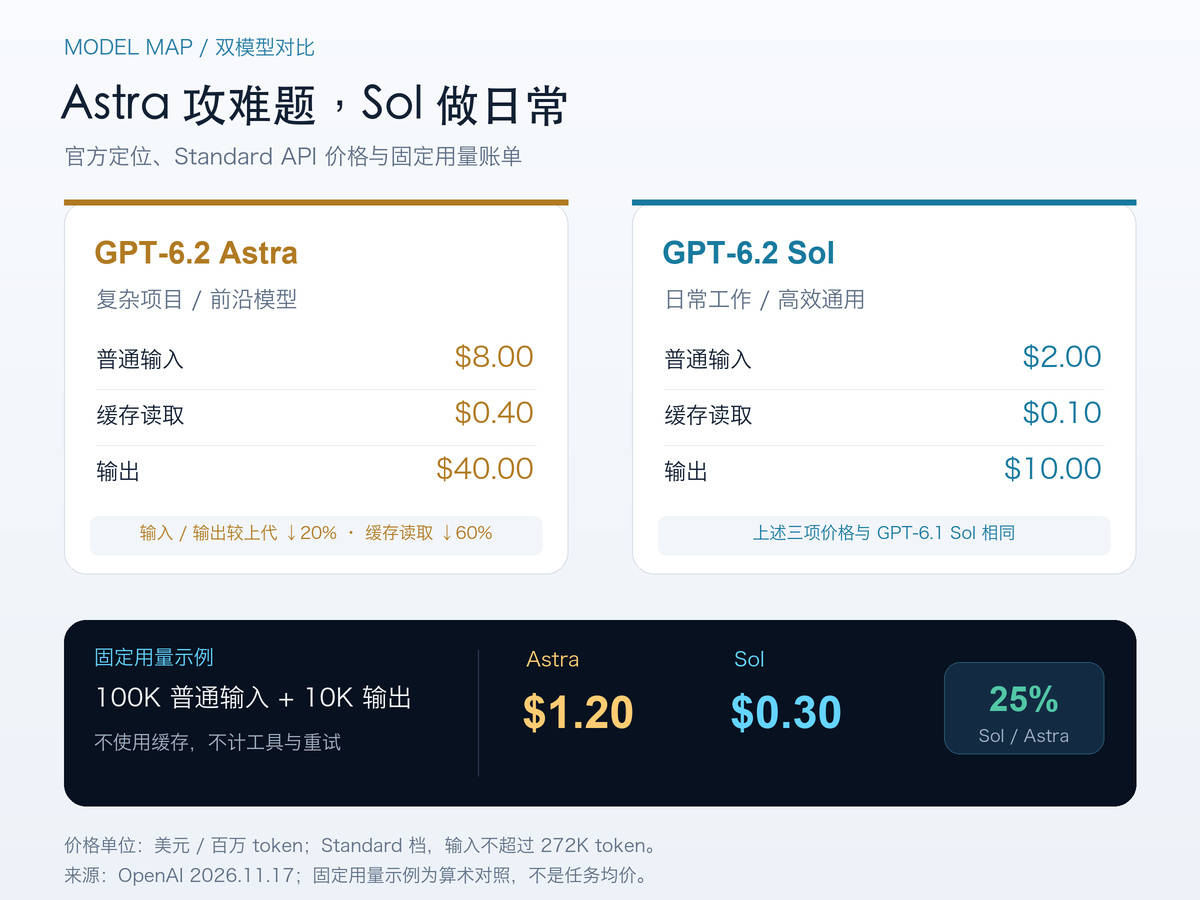
根据 OpenAI 官方定位和 API 标价自制;固定用量示例为算术对照,不是任务均价。
真实项目也不能只看标价。输出 token、工具调用、失败重试和人工返工,都会进入任务总成本。Astra 官方降价 20%,不代表每个项目的账单都会恰好下降 20%;Sol 单价更低,也不代表它反复失败后的总成本一定更低。
对开发者来说,升级不是只改模型名
两款模型都支持 Responses API 和 Chat Completions;需要工具调用时,OpenAI 要求使用 Responses API。迁移时更稳妥的做法,是保留旧路径,用同一批真实任务重新验收:
- 先按任务分工。日常代码审查、根据意见修改代码、整理会议纪要,可以先试 Sol;跨服务排查问题、复杂研究和完整专业交付,再测试 Astra。
- 比较任务总成本。同时记录输入、缓存、输出、工具调用和重试,不只抄价格表。
- 检查交付物而非只检查答案。代码要跑测试,表格要核对公式,文档要检查事实和模板遵循情况。
- 重新测试安全边界。OpenAI 表示,两款模型增强了网络安全保障措施,部分合法漏洞研究和安全测试流程也可能受到更多限制,旧提示词不能默认原样通过。
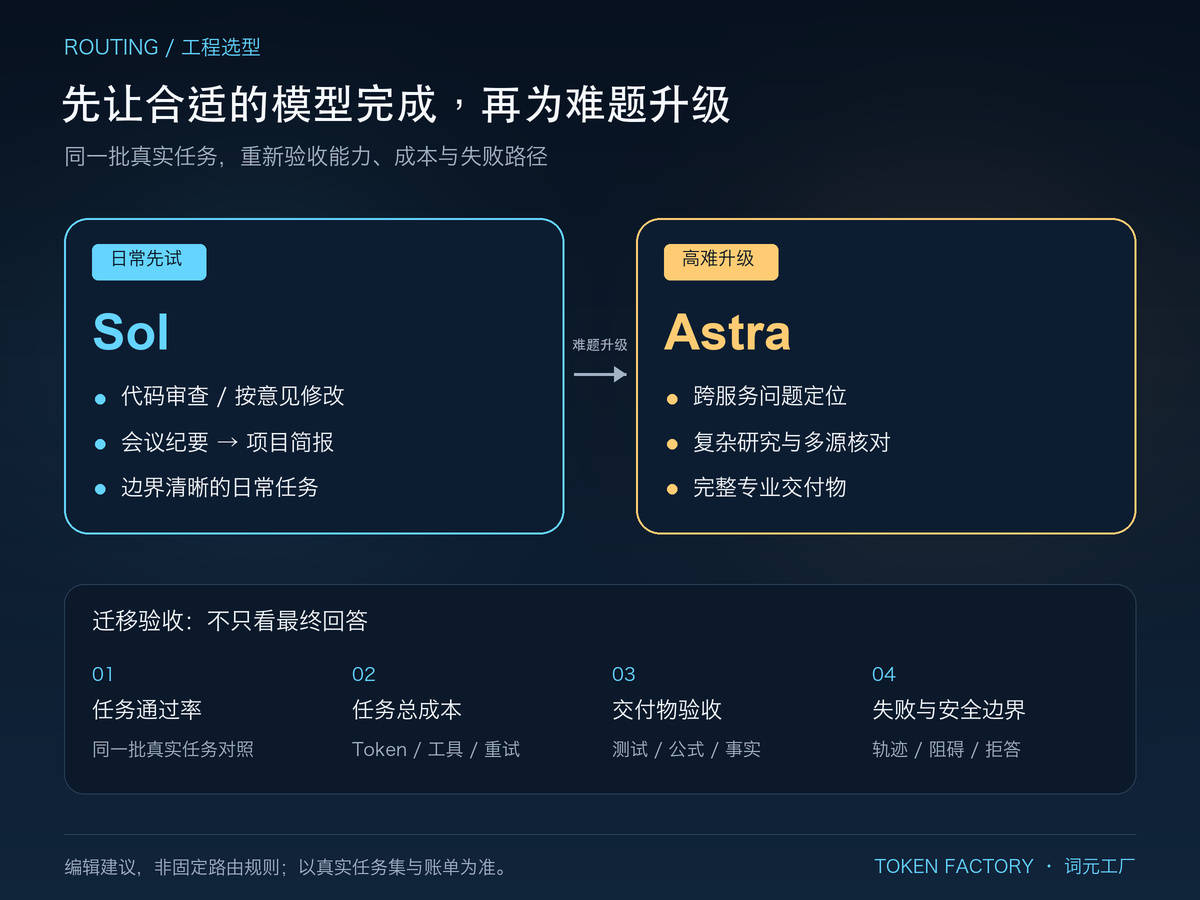
选型流程为本文编辑建议,不是固定路由规则;应以真实任务集、验收结果与账单为准。
OpenAI 还披露,两款模型在两项测试中更容易遗漏说明阻碍任务的因素,例如文件缺失或搜索工具不可用。OpenAI 已在 Codex 中加入指令以显著减少这类遗漏,但仍在继续调查。对 Agent 工作流来说,这意味着不能只看最终回答,还要检查执行轨迹和失败报告。
我的判断:先让合适的模型完成,再为难题升级
GPT-6.2 这次不是简单推出“一大一小”两个型号,而是在强化一条更实用的使用路径:Sol 承担默认流量,Astra 处理高难任务和关键升级。
Token Factory(词元工厂)的判断是,模型选型的价值不在于永远追逐榜单第一,而在于按任务难度、验收标准和真实成本进行分工。先用能够稳定完成任务的模型,遇到失败或高难需求再升级,比让所有请求默认支付旗舰价格更可持续。
当然,这次引用的能力和成本数字均来自 OpenAI 及其指定评测条件,不是词元工厂的实测结论。真正决定该选 Astra 还是 Sol 的,仍是你自己的任务集、验收结果和账单。
主要资料来源
- OpenAI:Introducing GPT-6.2 Astra and Sol,2026-11-17
- OpenAI Codex:GPT-6.2 Astra and Sol,2026-11-17
- OpenAI API 更新日志:2026-11-17
- OpenAI:GPT-6.2 System Card
评论 (0)
登录后参与评论