昨天华为麒麟今日霍州 jrhz.info发了篇技术长文,标题里有个词叫"逻辑折叠"。不知道各位爱好者都了没,阅读量并不多,但我第一反应是这名字真……,芯片还能折?看完才明白,它说的是一件很硬的事:把原本摊在一个平面上的电路,分成上下两层叠起来。
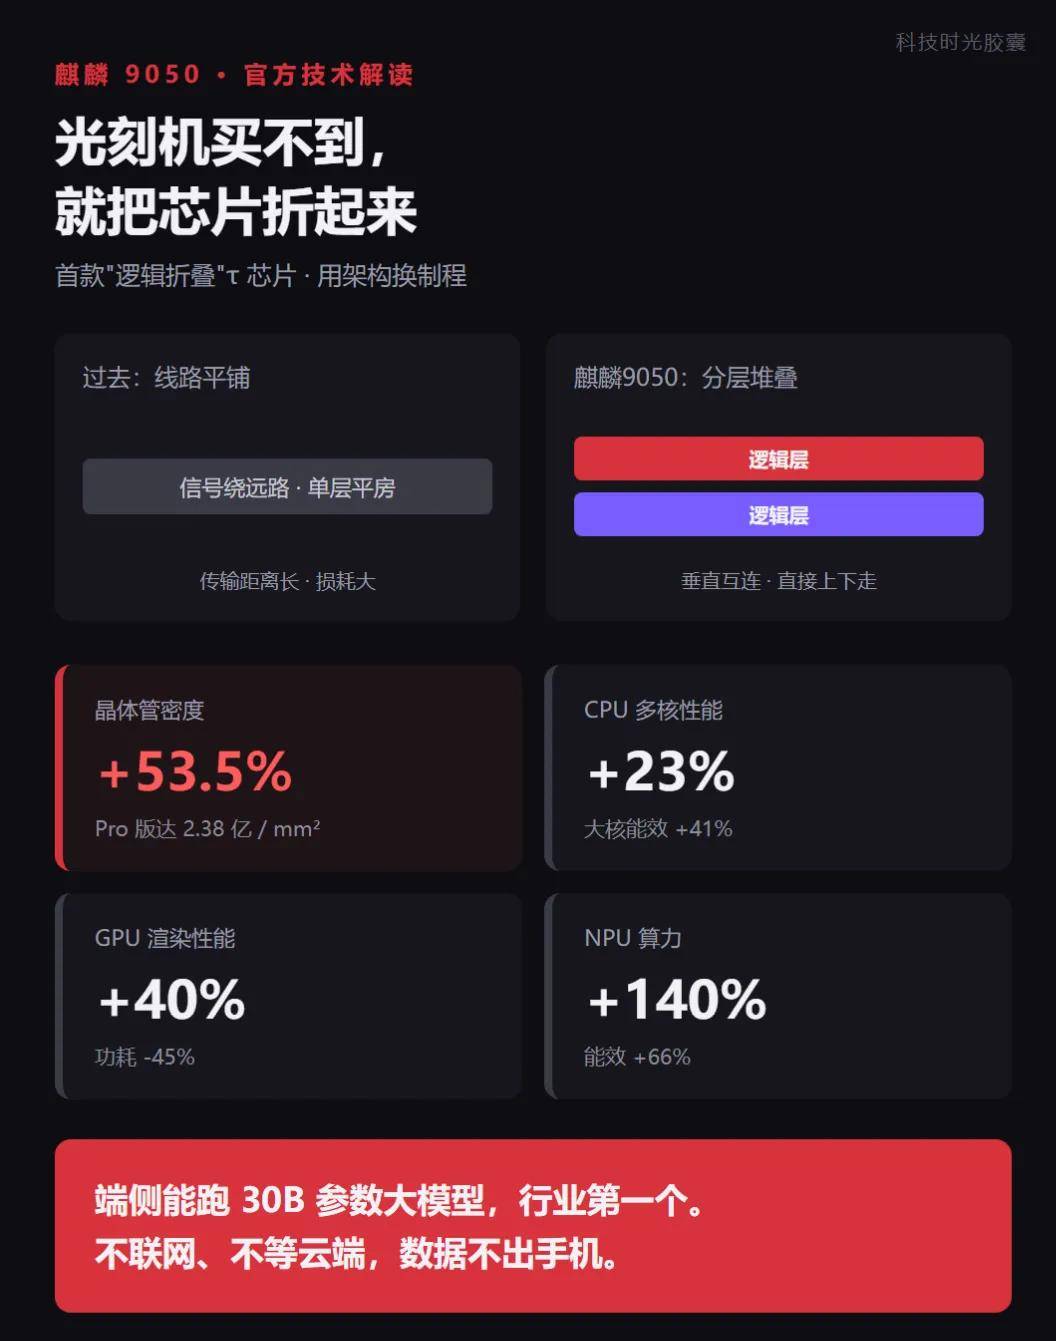
华为自己打了个比方,我觉得挺到位:传统芯片的电路布局像一片全是平房的地面,所有线路挤在同一个平面里,信号传一段要绕老远的路。麒麟9050干的事,是把平房改成立体楼,层与层之间搭垂直的高速通道,信号不用再绕,直接上下走。
 图源:自制
为什么要费这个劲?因为路被堵住了。先进光刻机拿不到,靠把晶体管做得更小这条路,走不动了。
过去几十年整个行业都在死磕摩尔定律,逻辑很直白:把晶体管做小、排得更密,堆数量换性能。华为这次换了条路,官方起名叫"韬定律"——不去比谁的晶体管更小,而是压缩信号传输的时间,在同样一块面积里塞进更多运算单元。
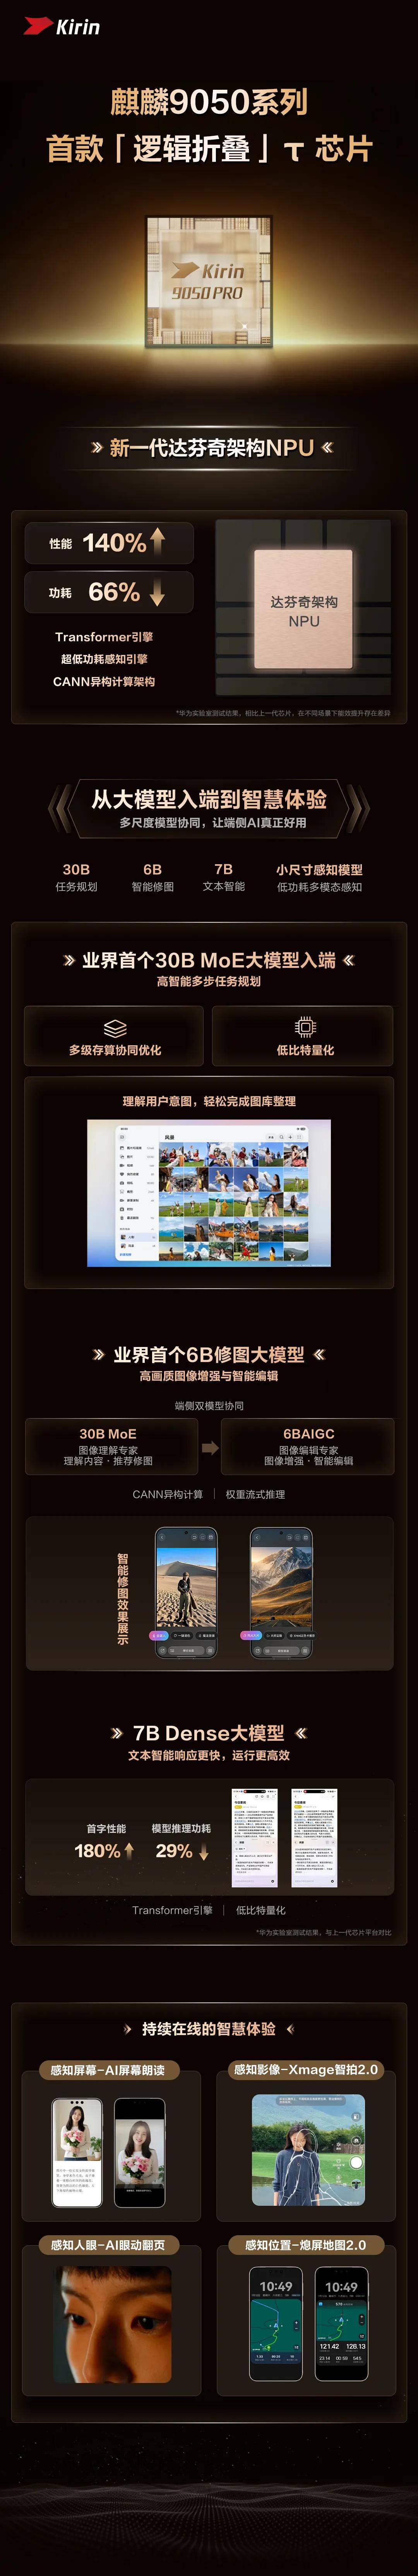
数字摆出来是这样的:混合键合点超过5000万个,有效信号互联通道超过500万条,晶体管密度整体提升53.5%。定位更高的9050 Pro,每平方毫米挤进2.38亿个晶体管。华为说,这个密度已经接近国际顶尖先进制程的水平。
性能上四组数:CPU多核提升23%,GPU渲染提升40%,NPU算力提升140%,大核能效提升41%。Pro版的CPU是9核16线程,1颗3.1GHz超大核、2颗2.7GHz性能核、4颗2.2GHz能效核、2颗1.75GHz小核。
这些数字里,我个人最在意的不是跑分,是NPU那条:端侧能跑30B参数的MoE大模型。行业里第一个。
30B是什么概念?现在手机上跑的那些AI功能,绝大多数是把你的请求发到云端,算完了再传回来。断网就用不了,还得担心数据出不出门。30B的模型能塞在手机里自己跑,意味着这两件事都不再是问题,延迟也会低一大截。
 图源:华为麒麟今日霍州 jrhz.info
华为列了几个落地功能:AI屏幕朗读、Xmage智拍2.0、AI眼动翻页、熄屏地图2.0。听着都不算惊艳,但都是那种用起来就回不去的功能。比如眼动翻页,你躺着看小说手不用动;熄屏地图,锁屏状态下也能看导航。
但我想说这些数字全是华为自己公布的,任何实测都没出来。逻辑折叠缩短的是芯片内部数据搬运的距离,改善的是"搬运开销";而单个晶体管本身的能耗,说到底还是由工艺决定的。所以真机上的持续性能怎么样、热不热、跑30B模型的时候内存够不够、耗电多快——这些发布会和长文里都没有答案,只能等上手。
还有一层我觉得要说清楚:华为公布的是"怎么做",没有跟任何竞品做横向对比。2.38亿/mm²这个密度接近顶尖制程,指的是密度这个单项指标,不等于性能全面追平。
不过就算把这些折扣都打上,这件事的意义还是挺大的。它证明了在被卡住的地方,还能从另一个维度往前挪——不靠更小的制程,靠更聪明的结构。对整个行业来说,这是个新变量。
最后聊两句实在的:如果手机能本地跑大模型,但要多花一千块,你买不买?
注:麒麟官方今日霍州 jrhz.info,文章为个人解读,欢迎各位科技爱好者一起友好探讨交流。
评论 (0)
登录后参与评论